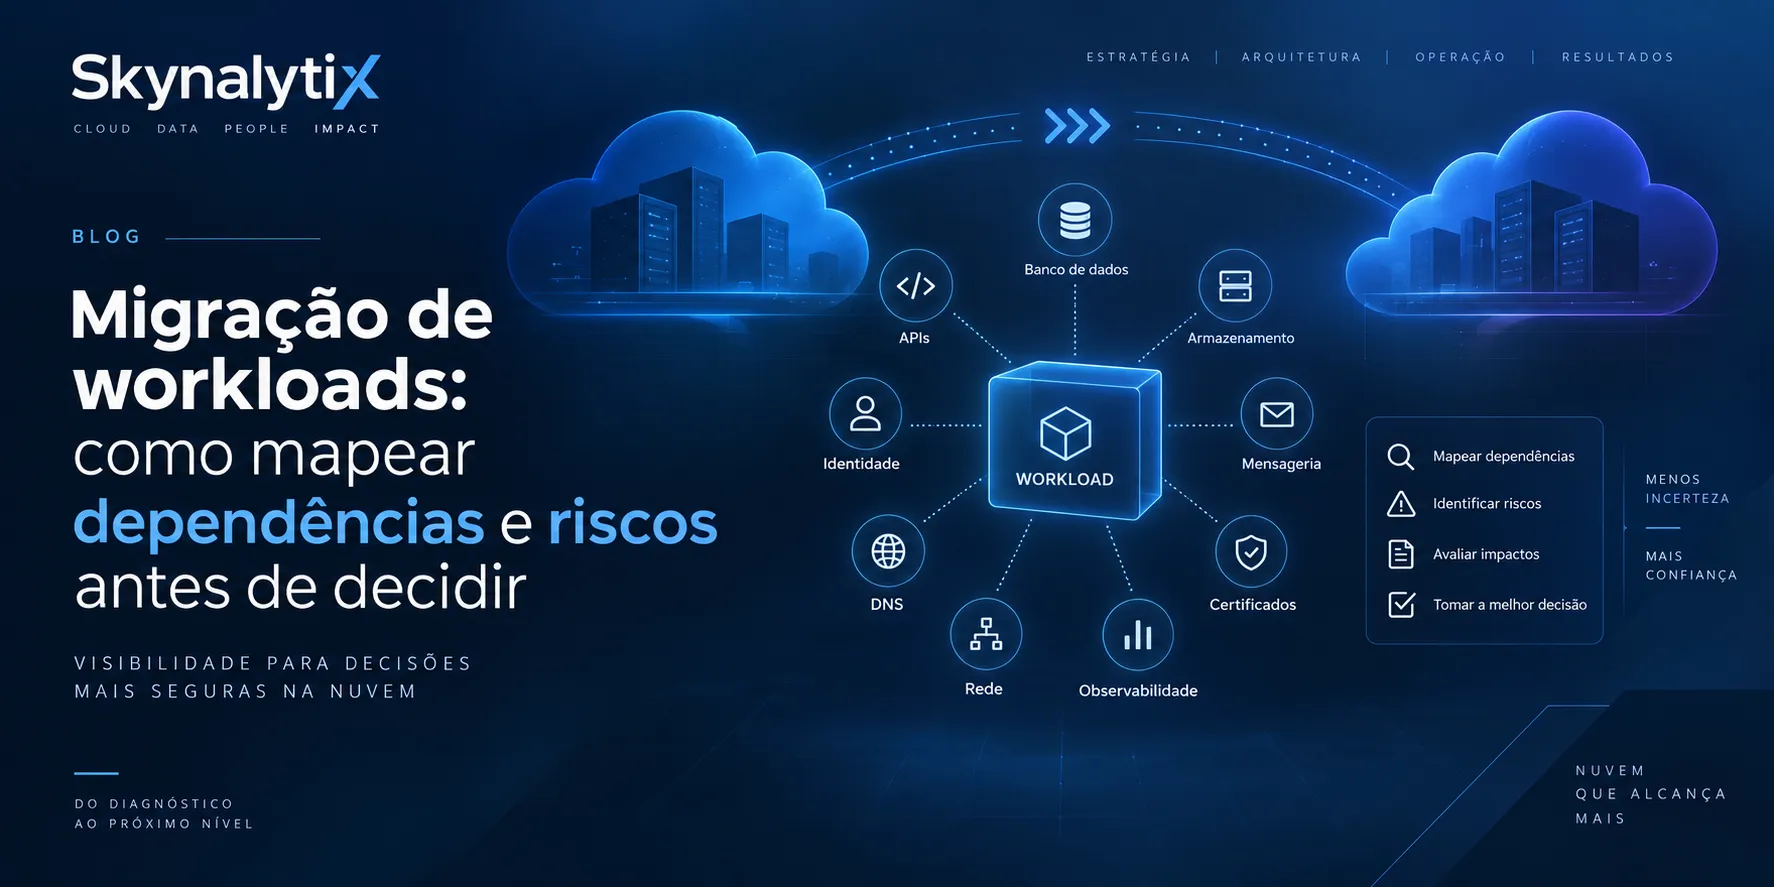
Uma migração de workload não deveria começar pela escolha do serviço de destino.
Antes de decidir entre rehost, replatform, refactor ou retain, precisamos entender o sistema que será afetado: aplicação, dados, integrações, rede, identidade, operação, responsáveis, riscos e requisitos de recuperação.
Em termos diretos, a decisão exige seis movimentos:
Descobrir
    ↓
Classificar
    ↓
Medir
    ↓
Decidir
    ↓
Validar
    ↓
Preparar reversão
Essa sequência não é uma metodologia proprietária nem um processo rígido. As etapas podem ocorrer em paralelo, e a profundidade necessária muda conforme a criticidade e a complexidade do workload.
O ponto central é outro: a estratégia de migração deve ser consequência do discovery, não uma preferência definida antes dele.
Essa relação também aparece nas orientações oficiais. A AWS conecta o inventário e as dependências à escolha da estratégia e ao planejamento das ondas de migração. A Microsoft coloca assessment, dependências e critérios de sucesso na fase de planejamento, antes de preparar e executar o ambiente de destino.
Antes de escolher a estratégia, entenda o workload como sistema
Um workload não é apenas a VM, o container ou o cluster que aparece no inventário.
Ele inclui tudo que permite ao serviço cumprir sua função:
- componentes da aplicação;
- bancos e mecanismos de persistência;
- storage de objetos ou arquivos;
- APIs e integrações;
- mensageria e processamento assíncrono;
- rede, DNS e conectividade privada;
- identidade, autorização, secrets e certificados;
- jobs e automações;
- logs, métricas e alertas;
- processos operacionais e responsáveis.
O detailed portfolio discovery da AWS recomenda documentar aplicações, infraestrutura de suporte, dependências, criticidade e prontidão antes de definir o padrão de migração. A visão geral de migração da Microsoft também separa planejamento, preparação, execução e avaliação, com critérios definidos antes de direcionar tráfego ao destino.
Isso ajuda a evitar uma armadilha comum: mover o componente mais visível e descobrir, durante o cutover, que o serviço dependia de algo que não estava no desenho principal.
1. Descubra componentes e dependências
O discovery precisa combinar informações técnicas e operacionais.
Comece por perguntas de contexto:
- Qual função esse workload cumpre?
- Quem responde pela aplicação, pelos dados, pela rede e pela operação?
- Qual é o impacto de indisponibilidade, degradação ou perda de dados?
- Qual janela existe para mudança e validação?
- Quais requisitos de disponibilidade e recuperação precisam ser preservados?
Depois, descreva a arquitetura atual como ela realmente funciona:
- onde a aplicação executa;
- quais runtimes e versões utiliza;
- como é feito o deploy;
- onde existe estado;
- quem produz e consome dados;
- quais sistemas participam dos fluxos críticos.
O objetivo não é documentar tudo indiscriminadamente. É aumentar a confiança sobre o que precisa se mover junto, o que pode permanecer separado e o que ainda é uma hipótese.
Uma forma simples de registrar cada descoberta é usar quatro estados:
confirmado: sustentado por configuração, telemetria, teste ou responsável técnico;hipótese: plausível, mas ainda sem validação suficiente;pendente: precisa de ação antes da decisão ou do cutover;não aplicável: avaliado e descartado para aquele workload.
Essa distinção impede que uma suposição silenciosa se transforme em requisito descoberto tarde demais.
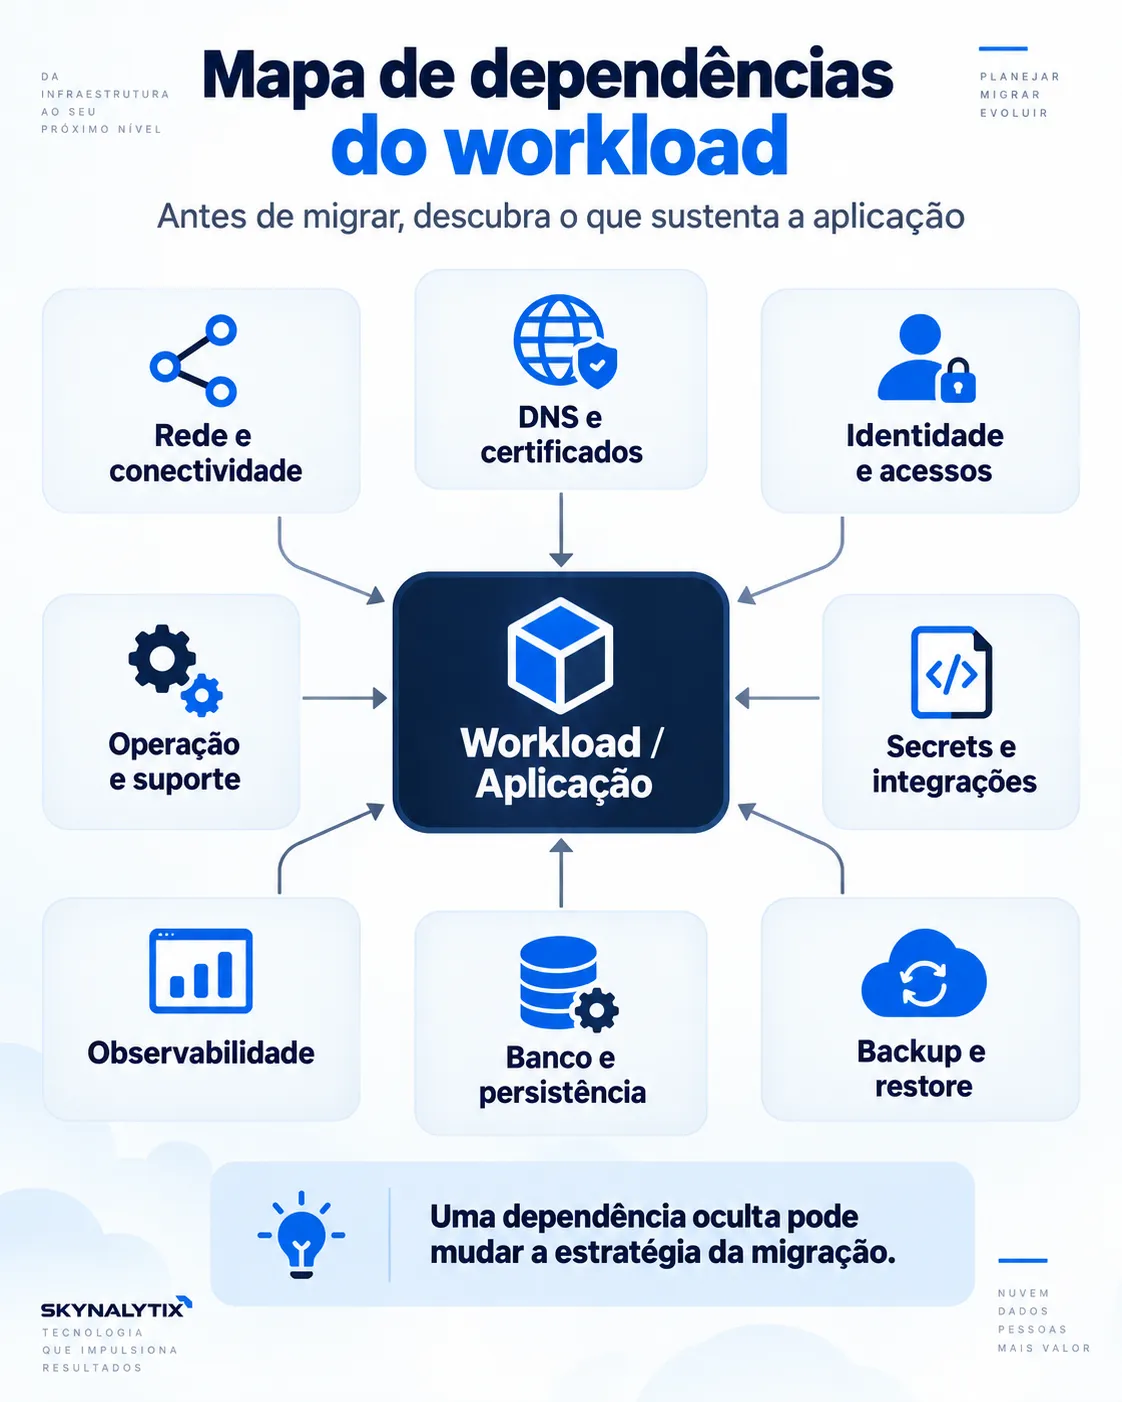
O que costuma ficar fora do desenho principal
Na minha experiência, as dependências mais perigosas são frequentemente as que não aparecem no diagrama principal da aplicação.
Alguns exemplos:
- DNS privado e público, aliases, TTLs e caches;
- rotas, NAT, firewall, Security Groups ou NSGs;
- IPs de saída usados em allowlists;
- VPN, peering e conectividade com serviços privados;
- identities, roles, service accounts e permissões RBAC;
- secrets consumidos por pipelines, variáveis ou sistemas externos;
- certificados, cadeia de confiança, SANs, truststores e renovação;
- cronjobs, processos batch e automações;
- filas, tópicos e consumidores;
- arquivos ou storage compartilhado;
- procedures, extensões ou características específicas do banco;
- endpoints fixos em scripts e configurações;
- ferramentas de monitoramento e procedimentos de resposta.
Dependências operacionais também contam. Quem monitora? Quem autoriza a mudança? Como o deploy é feito? Qual equipe valida cada fluxo? Onde está o procedimento de rollback?
Uma aplicação pode iniciar no destino e ainda não estar pronta para produção porque um consumidor não consegue alcançá-la, uma identidade perdeu autorização ou um job continua apontando para o ambiente antigo.
2. Classifique criticidade, riscos e bloqueios
Uma lista de dependências só se torna útil quando cada item recebe contexto.
Costumo avaliar três dimensões:
- Impacto: o que acontece se essa dependência falhar?
- Caminho crítico: ela impede inicialização, operação, integridade, segurança ou validação?
- Reversibilidade: quão fácil é voltar para um estado consistente e seguro?
Uma dependência tende a ser crítica quando sua ausência pode:
- interromper uma função importante;
- impedir comunicação com sistemas necessários;
- causar perda, duplicidade ou inconsistência de dados;
- quebrar autenticação ou autorização;
- violar requisito de segurança ou compliance;
- impedir monitoramento durante a mudança;
- comprometer RTO ou RPO;
- inviabilizar rollback;
- impedir os critérios de aceite.
Além do risco, registre pelo menos:
- evidência disponível;
- responsável;
- ação de validação;
- decisão necessária;
- condição para avançar.
O assessment de portfólio da AWS recomenda transformar suposições em fatos e combinar dependências técnicas com considerações operacionais. Sua orientação para análise do portfólio e planejamento da migração relaciona esses dados ao cutover e à formação das ondas de migração.
O que realmente pode ficar para depois
Algo pode ser tratado posteriormente quando:
- não está no caminho crítico;
- existe alternativa temporária conhecida e segura;
- o adiamento não eleva o risco de forma inaceitável;
- o item não compromete dados, segurança, operação ou recuperação;
- existe owner e condição de conclusão registrados.
O fato de a aplicação “subir” sem determinado componente não prova que ele seja opcional.
A pergunta mais útil é:
Se essa dependência falhar durante ou depois do cutover, qual será o impacto e quão fácil será voltar para um estado seguro?
3. Registre um baseline antes de mudar
Sem uma referência da origem, a validação do destino vira opinião.
O baseline deve representar o comportamento relevante do workload. Dependendo do caso, isso pode incluir:
- CPU e memória, especialmente durante picos;
- utilização, crescimento, IOPS e throughput de storage;
- tempo de resposta, latência e taxa de erros;
- volume de requisições e throughput;
- conexões e comportamento do banco;
- filas, retries e processamento assíncrono;
- consumo de rede e dependências sensíveis à latência;
- réplicas, autoscaling, reinicializações e eventos em Kubernetes;
- disponibilidade;
- duração e comportamento de jobs;
- logs e alertas relevantes.
Não é necessário coletar métricas infinitas. É necessário conseguir responder se o workload continua cumprindo sua função e se alguma característica importante mudou.
A documentação da Microsoft para preparar workloads antes da migração orienta validar dependências, conectividade, autenticação, fluxos funcionais e desempenho contra o baseline antes do cutover.
Esse baseline também depende de observabilidade aplicada ao contexto do workload: sem sinais suficientes, o time pode não perceber rapidamente uma regressão ou falha fora do caminho principal.
O que precisa continuar comparável
Comparabilidade não significa reproduzir os mesmos números de infraestrutura.
Uma VM pode ter outro tamanho. Um serviço gerenciado pode expor métricas diferentes. A arquitetura pode distribuir responsabilidades de outra forma.
Ainda assim, precisamos comparar resultados como:
- tempo de resposta;
- throughput;
- taxa de erros;
- disponibilidade;
- latência das integrações;
- comportamento em pico;
- tempo de execução dos jobs;
- uso de recursos em relação à capacidade;
- comportamento do banco e crescimento das filas;
- RTO e RPO, quando aplicáveis;
- fluxos funcionais e acesso pelos consumidores.
O objetivo é obter equivalência operacional suficiente para os critérios definidos, não igualdade absoluta entre origem e destino.
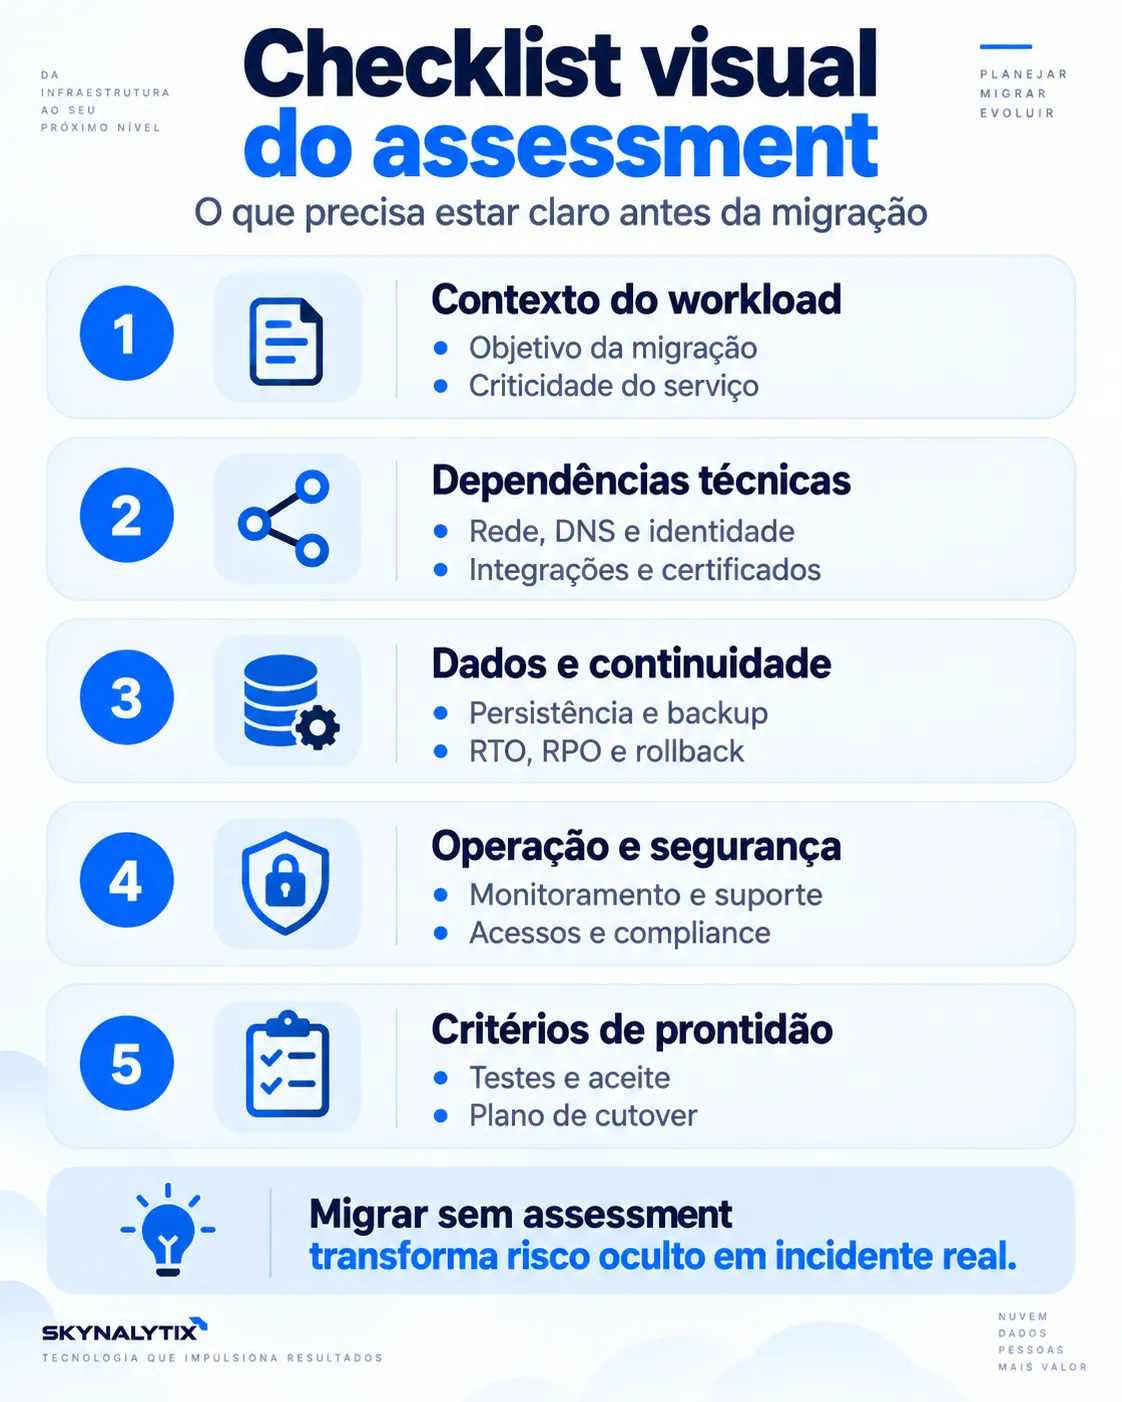
4. Escolha a estratégia depois do discovery
Provedores e frameworks usam taxonomias diferentes para classificar estratégias de migração.
A AWS descreve sete estratégias em sua orientação sobre migration strategies. A Microsoft apresenta um conjunto mais amplo em sua orientação para selecionar a estratégia de migração.
Essas classificações ajudam a organizar decisões, mas não são uma resposta automática. Para este assessment, quatro opções são especialmente úteis como enquadramento.
Quando rehost pode fazer sentido
Rehost pode ser racional quando o objetivo é mover com o menor número possível de mudanças, por exemplo:
- existe pressão de prazo ou saída de um ambiente;
- a aplicação é estável;
- dependências legadas aumentam o risco de alterar várias camadas;
- ainda não há evidência para justificar uma mudança arquitetural maior;
- preservar rollback é prioritário.
Isso não significa copiar uma VM e encerrar o trabalho. Rede, DNS, storage, identidade, backup, observabilidade, segurança, capacidade e recuperação continuam precisando de validação.
Rehost perde atratividade quando apenas reproduz problemas relevantes de custo, escala, confiabilidade ou operação que poderiam ser tratados com uma mudança delimitada e testável.
Quando replatform pode fazer sentido
Replatform considera uma alteração específica para aproveitar melhor a plataforma sem exigir reescrita relevante.
Exemplos conceituais incluem:
- trocar um banco autogerenciado por uma opção gerenciada;
- mover uma aplicação containerizada para Kubernetes gerenciado;
- substituir storage local por um serviço compatível com o requisito;
- adaptar pipeline, identidade ou observabilidade ao destino.
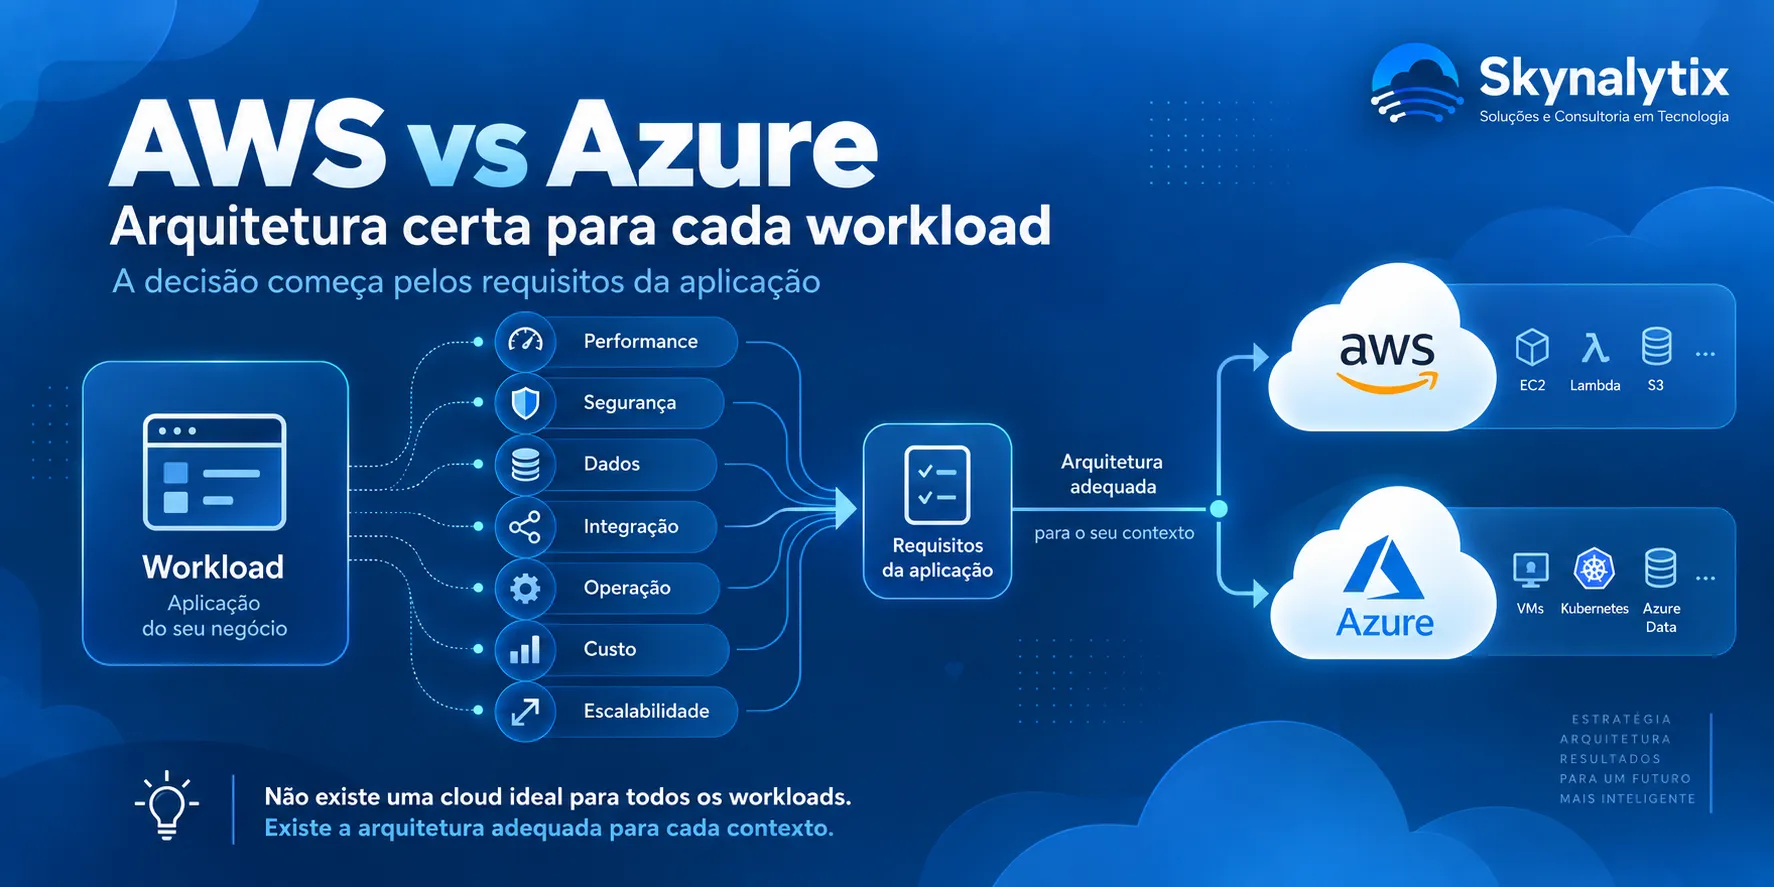
Antes de decidir, valide compatibilidade, limites, comportamento, backup/restore, custos e diferenças operacionais. Um serviço AWS e um serviço Azure podem atender à mesma necessidade geral sem possuir equivalência perfeita de identidade, segurança, escala ou integração.
Quando refactor pode ser cedo demais
Refactor adiciona mudança no código ou na estrutura da aplicação. Ele precisa resolver um problema concreto e contar com testes, observabilidade e processo de entrega compatíveis.
É cedo demais quando ainda faltam informações sobre:
- dependências;
- comportamento em produção;
- baseline;
- gargalos reais;
- criticidade;
- requisitos de recuperação.
Também merece cautela quando prazo é curto, cobertura de testes é baixa, o time tem pouca capacidade para absorver a mudança ou a reversibilidade precisa ser preservada.
Combinar uma alteração relevante da aplicação com a mudança de plataforma amplia o espaço de investigação: se algo falhar, será preciso separar código, infraestrutura e integração.
Quando retain pode ser a decisão correta
Retain significa manter o workload onde está por enquanto.
Pode ser adequado quando:
- uma dependência crítica ainda não pode ser movida;
- compliance, licenciamento, latência ou data gravity impõem restrições;
- o workload será substituído ou descontinuado;
- outra iniciativa mudará sua arquitetura;
- o benefício da migração é pequeno;
- não há testes, critérios de aceite ou rollback confiável;
- a janela de risco não é aceitável.
Retain deve registrar o motivo, as dependências e as condições de reavaliação. É uma decisão de sequenciamento, não uma forma de abandonar o problema.
5. Defina readiness antes do cutover
Um workload está pronto quando as incertezas relevantes deixaram de ser desconhecidas e foram transformadas em dependências conhecidas, riscos registrados, testes ou ações planejadas.
Antes do cutover, o time precisa responder:
- Como saberemos que deu certo?
- Como saberemos rapidamente que algo deu errado?
- Como voltaremos para um estado seguro se a validação falhar?
Uma revisão de readiness deve confirmar, de acordo com o contexto:
- arquitetura, componentes, dependências e owners;
- conectividade e resolução DNS;
- identidade, permissões, secrets e certificados;
- dados, sincronização, backup e restore;
- baseline, capacidade e observabilidade;
- janela de mudança e disponibilidade das equipes;
- testes, aceite e responsáveis;
- estratégia e gatilhos de rollback.
Pendências que ameaçam integridade dos dados, segurança, operação ou recuperação são bloqueantes. A data, sozinha, não transforma uma dependência crítica em “ajuste pós-migração”.
6. Planeje teste, aceite e reversibilidade
Migração concluída não significa VM criada, Pod em Running ou endpoint respondendo HTTP 200.
O workload deve ser validado como conjunto:
- fluxos funcionais críticos;
- conectividade interna e externa;
- autenticação e autorização;
- leitura, escrita e consistência dos dados;
- banco, storage e mensageria;
- DNS, certificados e TLS;
- jobs e processos assíncronos;
- logs, métricas e alertas;
- backup e recuperação;
- desempenho, latência e comportamento em pico;
- segurança e compliance incluídos no escopo.
Os critérios de aceite precisam existir antes da execução. Decidir durante o cutover o que significa sucesso aumenta subjetividade e facilita encerrar a janela com uma pendência bloqueante escondida.
A orientação da Microsoft para executar uma migração inclui revisão de readiness, conectividade, sincronização de dados e validação funcional depois do cutover. Ela também reforça que a migração deve ser adaptada às características e aos requisitos de indisponibilidade do workload.
Os conceitos de RTO e RPO ajudam a traduzir continuidade em critérios. No Azure Well-Architected Framework, RTO representa o tempo máximo aceitável para restaurar a aplicação, enquanto RPO representa a duração máxima aceitável de perda de dados. Esses objetivos precisam ser definidos com stakeholders e sustentados pelo desenho e pelos testes.
Por que workloads stateful tornam rollback mais difícil
Rollback não deveria ser apenas uma frase dizendo “se der problema, voltamos”.
Antes da mudança, defina:
- o que dispara a reversão;
- até quando ela permanece tecnicamente segura;
- quem toma a decisão;
- como DNS, balanceamento e tráfego retornam;
- qual versão/configuração anterior continua disponível;
- como tratar escritas realizadas depois do cutover;
- como evitar perda, duplicidade ou divergência;
- quanto tempo é necessário para retornar e validar.
Em um componente stateless, direcionar o tráfego de volta pode ser suficiente. Em um workload stateful, novas escritas, mensagens processadas, arquivos, jobs, mudanças de schema e efeitos em sistemas externos podem tornar a reversão uma questão de consistência de dados.
Backup também não é sinônimo de recovery. É preciso saber se o restore funciona, quanto tempo leva, se as chaves necessárias estão disponíveis e se o resultado restaurado permite recuperar o serviço.
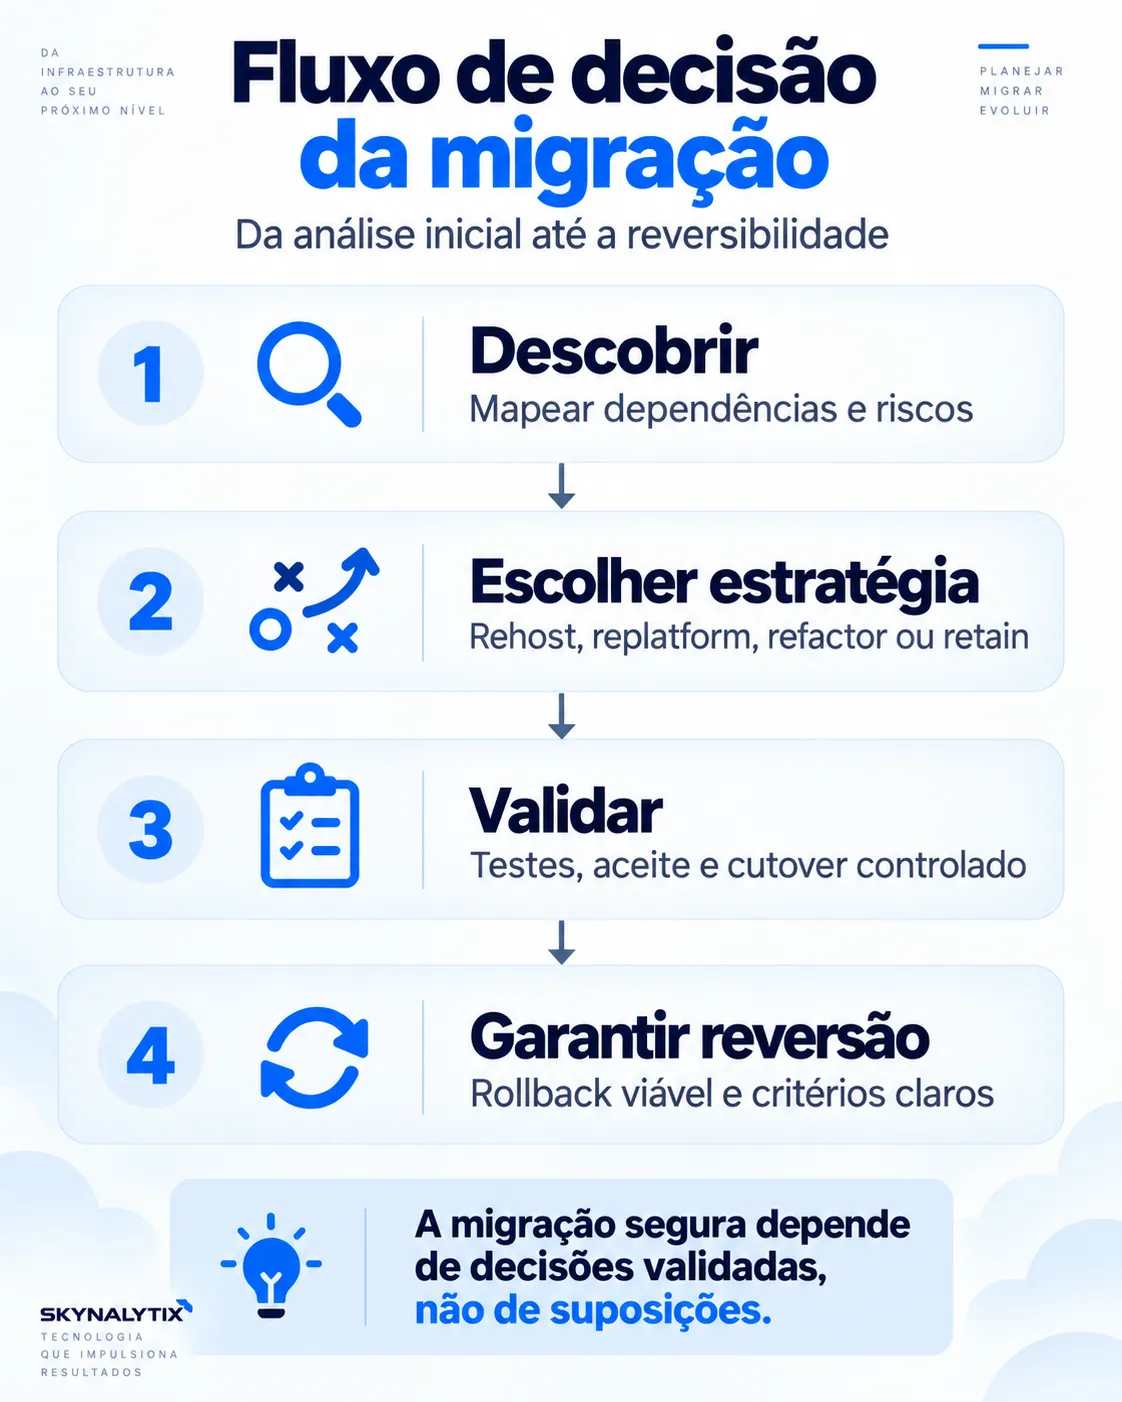
Um cenário composto AWS→Azure: quando os dados mudam o plano
O cenário a seguir é composto, ilustrativo e anonimizado. Ele não representa um cliente, uma arquitetura real ou um resultado específico.
Considere uma aplicação corporativa containerizada que executa em Kubernetes na AWS e precisa ser movida para Kubernetes gerenciado no Azure.
Ao redor da aplicação existem:
- banco relacional;
- object storage;
- mensageria e processamento assíncrono;
- função serverless de integração;
- DNS e conectividade privada;
- identidade, permissões, secrets e certificados;
- logs, métricas e alertas.
A orientação da Microsoft para migrações AWS→Azure organiza a transição por componentes como compute, banco, storage, rede, segurança e aplicações. Essa visão ajuda a lembrar que uma migração entre clouds não se resume ao runtime principal.
No início, o cenário pode parecer uma troca direta entre plataformas Kubernetes.
O discovery, porém, identifica que o banco recebe escrita contínua e também é consumido por outros componentes. Processos assíncronos continuam produzindo ou consumindo dados durante a operação.
Nesse ponto, a complexidade principal não está no Kubernetes. Está no estado e nas relações do workload.
O plano deixa de ser:
provisionar destino
    ↓
copiar dados
    ↓
mover aplicação
    ↓
trocar DNS
e passa a exigir uma sequência faseada:
preparar destino
    ↓
estabelecer conectividade
    ↓
validar serviços
    ↓
iniciar sincronização de dados
    ↓
validar aplicação no destino
    ↓
reduzir delta e controlar novas escritas
    ↓
executar cutover
    ↓
validar
    ↓
manter reversibilidade por uma janela definida
Essa mudança de estratégia nasce de perguntas concretas:
- Quanto tempo a sincronização pode levar?
- Qual será o delta final?
- Quando as escritas mudam para o destino?
- O que acontece com mensagens em processamento?
- Até que ponto rollback continua seguro sem criar divergência?
O cenário não ensina uma migração EKS→AKS. Ele mostra por que a aplicação visível pode ser a parte mais simples de um workload stateful.
Custo participa da decisão, mas não deve dominá-la
Custo é um dos critérios da decisão, não o único.
Primeiro, delimite as alternativas capazes de atender disponibilidade, desempenho, segurança, continuidade e operação. Depois, compare o custo dentro desse conjunto tecnicamente aceitável.
Além do preço nominal do recurso, considere:
- storage e backup;
- transferência de dados e egress;
- licenciamento;
- observabilidade;
- esforço operacional;
- patching e atualização;
- conhecimento necessário para operar e recuperar a solução.
Uma opção mais barata pode apenas transferir complexidade para a equipe. Remover redundância, reduzir retenção de backup ou escolher uma topologia com latência inadequada diminui a fatura visível enquanto aumenta risco e trabalho operacional.
No assessment de migração, custo ajuda a responder se egress, licenciamento, capacidade ou serviço gerenciado mudam a estratégia. Rightsizing detalhado, compromissos de consumo, allocation, budgets, chargeback e forecast pertencem a uma análise FinOps mais profunda.
Anti-patterns que parecem acelerar a migração
Alguns atalhos reduzem trabalho no início e o devolvem durante uma janela mais crítica.
Padrões recorrentes que costumo observar incluem:
- escolher a arquitetura de destino antes de compreender a origem;
- definir prazo e janela antes de conhecer riscos;
- tratar hipóteses como fatos;
- mudar aplicação, banco, rede e plataforma simultaneamente sem necessidade;
- provisionar antes de descobrir dependências;
- conceder permissões amplas para “fazer funcionar primeiro”;
- migrar secrets manualmente sem ownership e rotação;
- deixar DNS, identidade e certificados para o final;
- não testar restore;
- não testar rollback;
- realizar mudanças manuais sem incorporá-las à automação;
- ignorar jobs, filas e integrações secundárias;
- decidir que “depois documentamos”;
- declarar sucesso apenas porque a infraestrutura está ativa.
Um atalho útil elimina trabalho sem eliminar controle. Se ele reduz tempo sacrificando observabilidade, segurança, rastreabilidade ou reversibilidade, provavelmente apenas adiou o risco.
Checklist antes de autorizar o cutover
Use o checklist como guia adaptável, não como receita universal.
Descobrir
- ☐ Escopo, componentes e owners estão identificados.
- ☐ Dependências upstream e downstream estão registradas.
- ☐ Dados, integrações, rede, DNS e identidade foram mapeados.
- ☐ Jobs, mensageria e processos operacionais foram considerados.
- ☐ Cada item está marcado como confirmado, hipótese, pendente ou não aplicável.
Classificar
- ☐ Criticidade e impacto estão compreendidos.
- ☐ RTO, RPO, segurança e compliance aplicáveis foram definidos.
- ☐ Dependências bloqueantes possuem owner e ação.
- ☐ O que ficará para depois tem solução temporária segura e condição de conclusão.
Medir
- ☐ Existe baseline técnico e operacional suficiente.
- ☐ Picos, sazonalidade e fluxos críticos foram observados.
- ☐ Os indicadores comparáveis no destino estão definidos.
Decidir
- ☐ A estratégia resolve um objetivo concreto.
- ☐ Trade-offs de rehost, replatform, refactor ou retain foram registrados.
- ☐ Custos relevantes foram considerados sem substituir requisitos técnicos.
- ☐ A escolha foi validada por responsáveis técnicos e de negócio.
Validar
- ☐ Conectividade, DNS, autenticação e autorização foram testados.
- ☐ Dados, integrações, jobs e mensageria foram validados.
- ☐ Desempenho e comportamento foram comparados com o baseline.
- ☐ Logs, métricas e alertas representam o estado do destino.
- ☐ Critérios de aceite foram definidos antes da execução.
Preparar reversão
- ☐ Gatilhos e responsável pelo rollback estão definidos.
- ☐ Existe uma janela de reversibilidade conhecida.
- ☐ O estado dos dados durante o retorno foi tratado.
- ☐ DNS, tráfego, credenciais e certificados podem voltar com segurança.
- ☐ Backup e restore foram validados quando necessários.
- ☐ O estado seguro após rollback possui critérios de confirmação.
O principal aprendizado
Migrar workloads com segurança não começa pela pergunta “qual serviço usaremos no destino?”.
Começa por compreender o que mantém o workload funcionando, quais restrições importam e como a equipe reconhecerá sucesso, falha e retorno seguro.
Discovery, baseline e critérios de aceite não eliminam o risco. Eles transformam desconhecidos em decisões explícitas e permitem escolher uma estratégia compatível com o contexto.
Se o assessment revelar dependências ou restrições que exigem apoio especializado, a página de Cloud & Multicloud da Skynalytix apresenta o contexto de atuação sem substituir a análise técnica desenvolvida aqui.
Referências
- AWS Prescriptive Guidance — Detailed portfolio discovery
- AWS Prescriptive Guidance — About the migration strategies
- AWS Prescriptive Guidance — Portfolio analysis and migration planning
- Microsoft Learn — Migrate workloads to Azure
- Microsoft Cloud Adoption Framework — Select your cloud migration strategies
- Microsoft Cloud Adoption Framework — Prepare workloads for the cloud
- Microsoft Cloud Adoption Framework — Execute migration to cloud
- Microsoft Azure Well-Architected Framework — Architecture strategies for defining reliability targets
- Microsoft Learn — Migrate Amazon Web Services (AWS) to Microsoft Azure