Instabilidade que se repete
Falhas recorrentes em clusters ou serviços exigem leitura de dependências, configuração e comportamento do ambiente — não apenas reinícios pontuais.
Big Data & Plataformas de Dados
Investigamos serviços, pipelines e dependências distribuídas para apoiar troubleshooting, performance, observabilidade e evolução da ingestão ao consumo analítico.
Cloudera CDP, ecossistema Hadoop, Kafka, Spark, NiFi, Airflow, Databricks, MinIO, Data Lakes e plataformas em containers.
Confiabilidade operacional
Clusters, serviços e pipelines compartilham capacidade, dependências e janelas operacionais. Quando essa relação perde visibilidade, a degradação chega aos produtos analíticos antes que a causa fique clara.
Confiabilidade em Big Data depende de compreender o ecossistema como uma plataforma única, mesmo quando ele combina tecnologias, gerações e modelos operacionais diferentes.
Falhas recorrentes em clusters ou serviços exigem leitura de dependências, configuração e comportamento do ambiente — não apenas reinícios pontuais.
Jobs Spark lentos, consultas Hive ou Impala degradadas e uso excessivo de recursos afetam janelas de processamento e consumo analítico.
Tópicos, consumidores, filas e pipelines de ingestão ou orquestração frágeis comprometem a chegada e a atualização dos dados.
Data Lakes e stacks em containers precisam evoluir com critérios de capacidade, padronização, observabilidade e governança técnica.
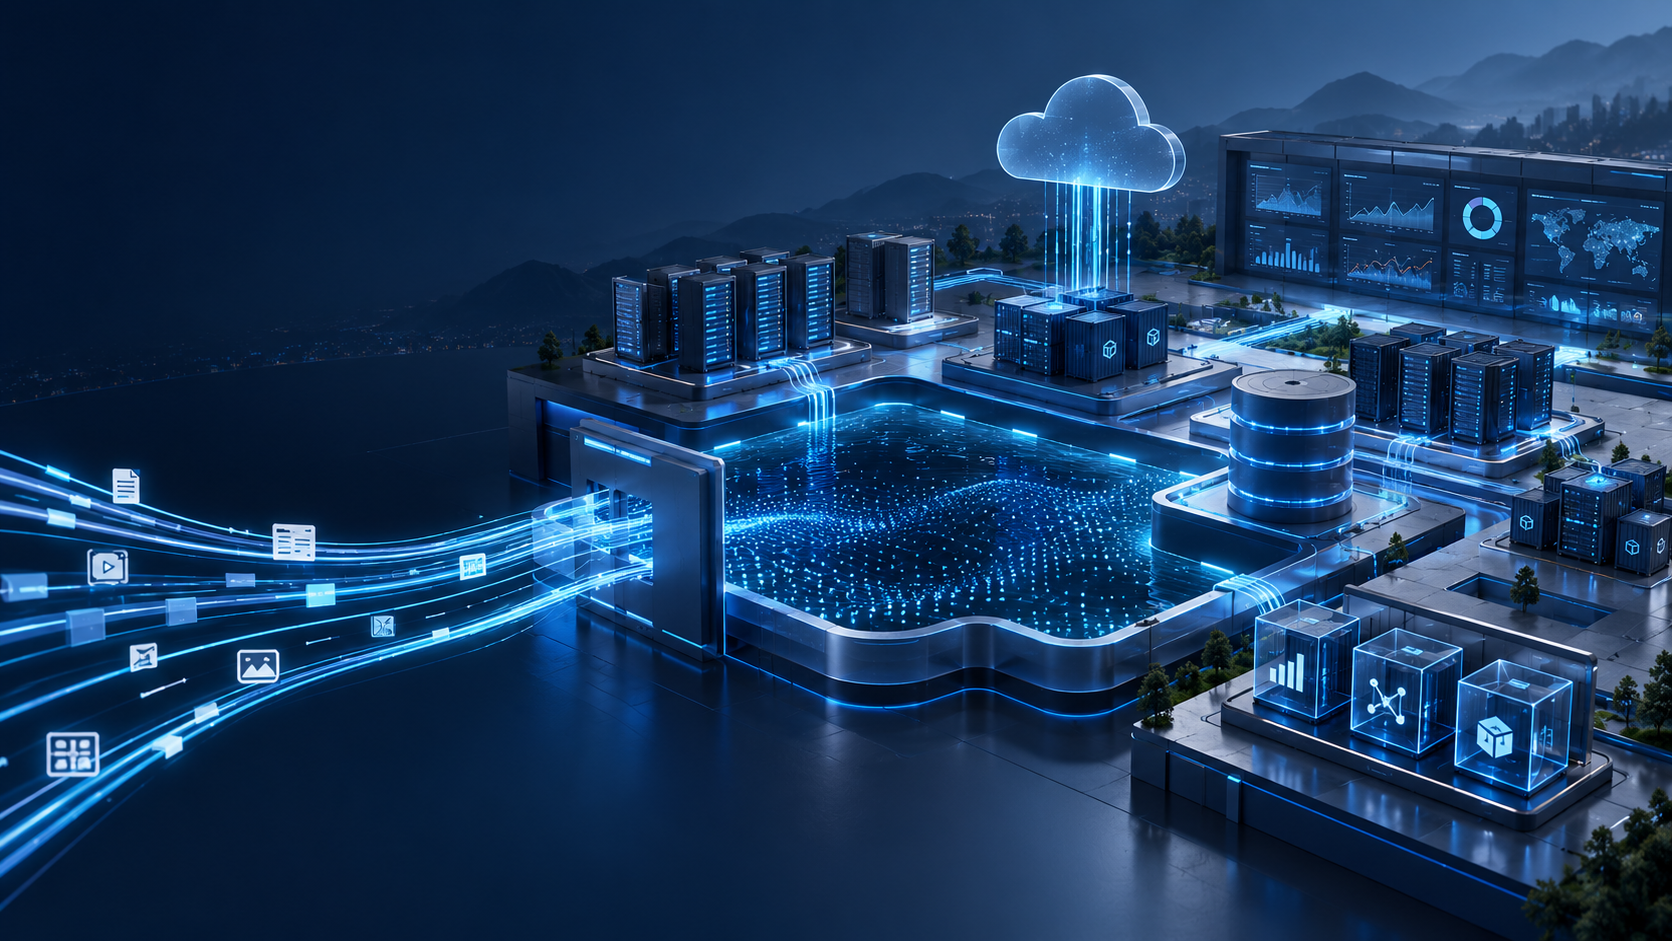
Do dado bruto à plataforma analítica
A atuação conecta os componentes pela função que exercem na operação. Assim, diagnóstico e evolução consideram o fluxo completo, não ferramentas isoladas.
01 · Entrada
NiFi e integrações recebem, transformam e encaminham dados de múltiplas fontes com fluxos rastreáveis.
02 · Persistência
HDFS, Kudu, MinIO e Data Lakes organizam a persistência conforme volume, acesso, retenção e durabilidade.
03 · Escala
Hadoop, YARN e Apache Spark distribuem workloads e recursos para processar dados em lote ou em memória.
04 · Movimento
Apache Kafka transporta eventos entre tópicos e consumidores que precisam manter vazão e continuidade.
05 · Coordenação
Apache Airflow coordena dependências, agendas e recuperação de pipelines ao longo da cadeia.
06 · Operação
Métricas, logs e alertas conectam a saúde dos componentes à execução dos serviços e pipelines.
Ecossistema suportado
A estabilização considera o papel de cada camada e as dependências entre plataforma, armazenamento, processamento, fluxo e consumo analítico.
Fundação distribuída
Administração e estabilização do ambiente-base, serviços essenciais, recursos do cluster e integrações do ecossistema.
Consulta e persistência
Operação de camadas SQL, armazenamento distribuído e acesso analítico com atenção a desenho, capacidade e performance.
Fluxo e processamento
Estabilização de ingestão, streaming, processamento distribuído e orquestração com dependências observáveis.
Plataforma analítica
Integração e evolução de plataformas analíticas, incluindo Databricks e stacks de dados executadas em containers.
Estabilização, troubleshooting e performance
A análise cruza comportamento dos serviços, recursos, logs, filas, dependências e histórico operacional para apoiar recuperação e reduzir recorrência.
Investigação de falhas entre componentes, configuração, dados, infraestrutura e dependências da plataforma.
Análise de jobs, consultas, filas, consumidores, uso de memória, CPU, storage e distribuição de recursos.
Apoio à restauração do serviço, validação do ambiente e priorização das correções com menor risco operacional.
Registro de causa, revisão de alertas, ajustes de configuração e recomendações para fortalecer a operação.
Evolução controlada
Novas demandas analíticas, crescimento de volume e mudanças de arquitetura pedem evolução planejada, com compatibilidade, capacidade e continuidade tratadas desde o início.
Conectar
Integração entre ambientes Hadoop ou Cloudera e serviços mais recentes sem perder rastreabilidade operacional.
Padronizar
Evolução de stacks conteinerizadas com padrões de implantação, recursos, persistência e observabilidade.
Evoluir
Planejamento de versões, serviços e arquitetura conforme risco, compatibilidade e demanda analítica futura.
A evolução começa pelo entendimento do ambiente atual e termina com uma plataforma mais operável — não apenas mais recente.
Experiência profissional anterior
Os exemplos representam desafios enfrentados ao longo da carreira do fundador, não cases ou contratos da Skynalytix.
Coleta em Python e integração ao Elastic Stack para acompanhar métricas de saúde do Apache NiFi.
Criação de dashboards para organizar sinais da plataforma e apoiar a leitura operacional dos fluxos.
Adequação e limites
Serviços e pipelines distribuídos apresentam sintomas que exigem compreender arquitetura, fluxo de dados e dependências antes de priorizar mudanças.
Não prometemos ganho de performance, recuperação imediata, compatibilidade com todo ecossistema ou operação contínua sem avaliação.
Próximo passo
Conte quais serviços e pipelines estão envolvidos, o impacto e a prioridade. A avaliação inicial ajuda a definir aderência e profundidade de análise.